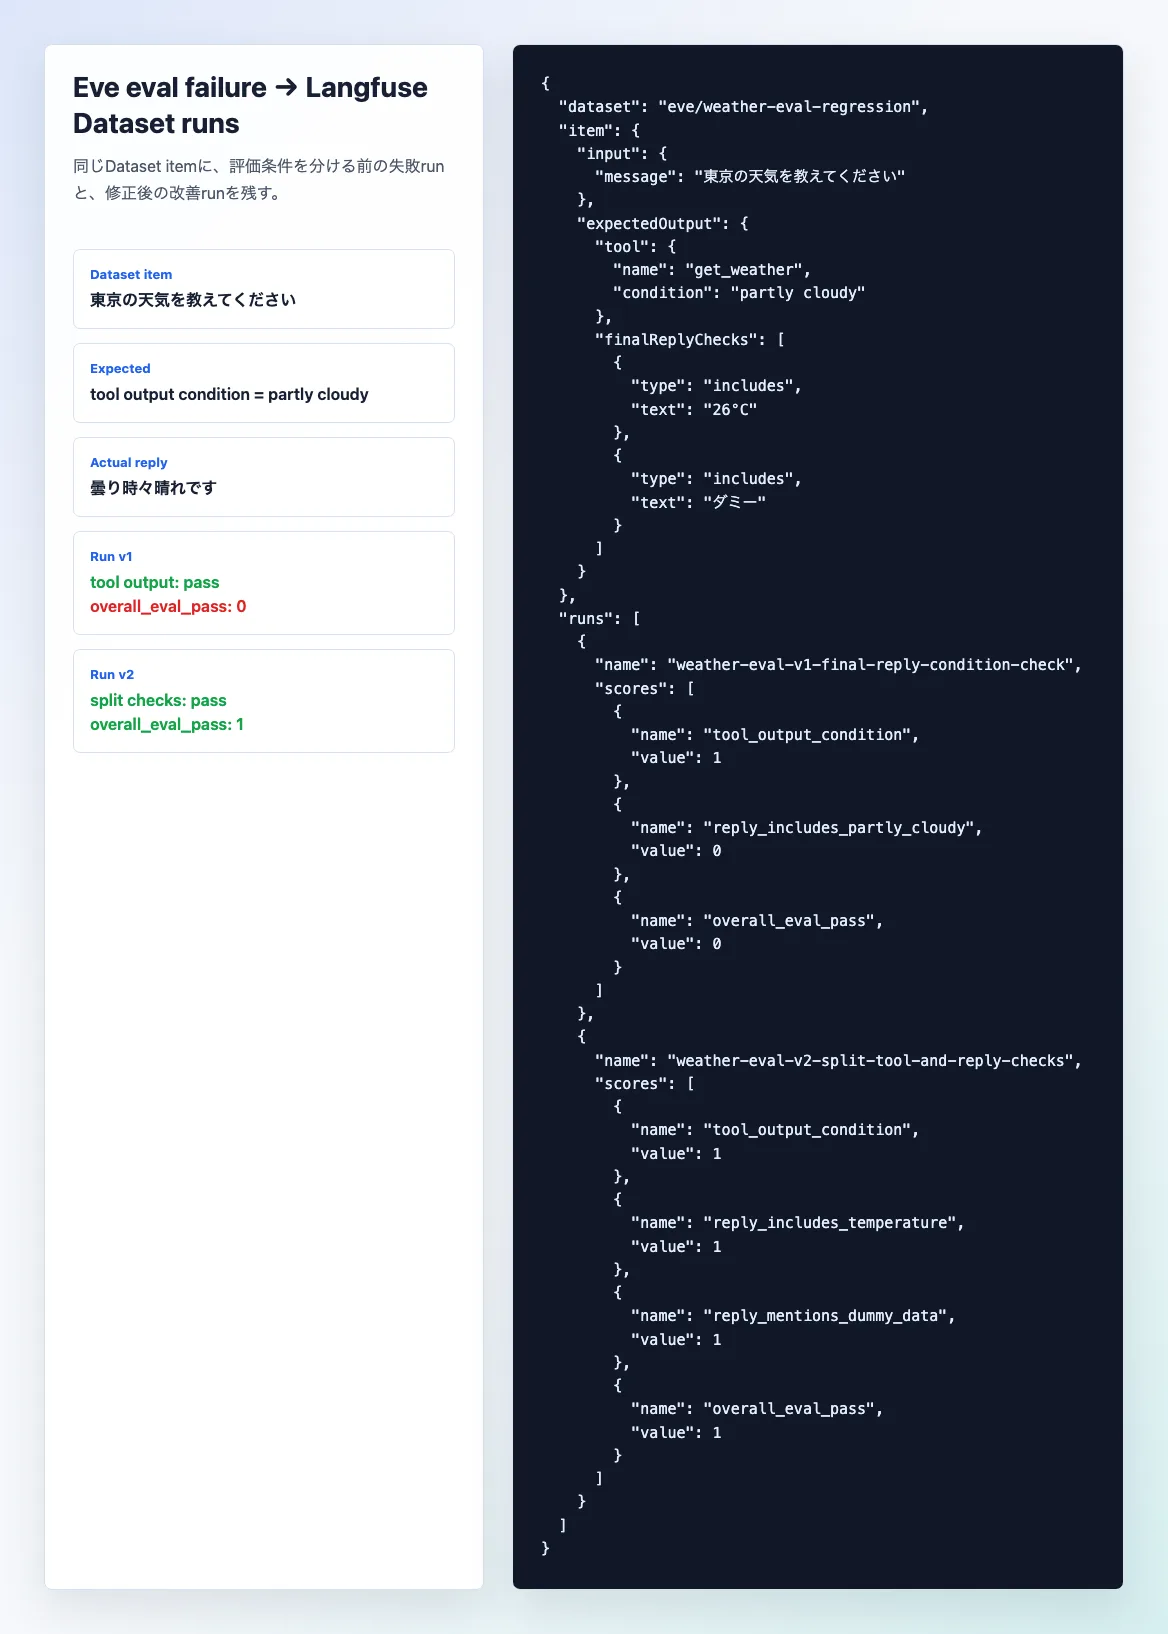
Eveのeval失敗ログをLangfuse Datasetに残して評価条件を改善する
Eveの評価で一度落ちた天気ツールの失敗ログをLangfuse Datasetに登録し、失敗runと修正後runを比較しながら評価条件を改善する検証ログ。
Eveの評価で一度落ちた天気ツールの失敗ログをLangfuse Datasetに登録し、失敗runと修正後runを比較しながら評価条件を改善する検証ログ。
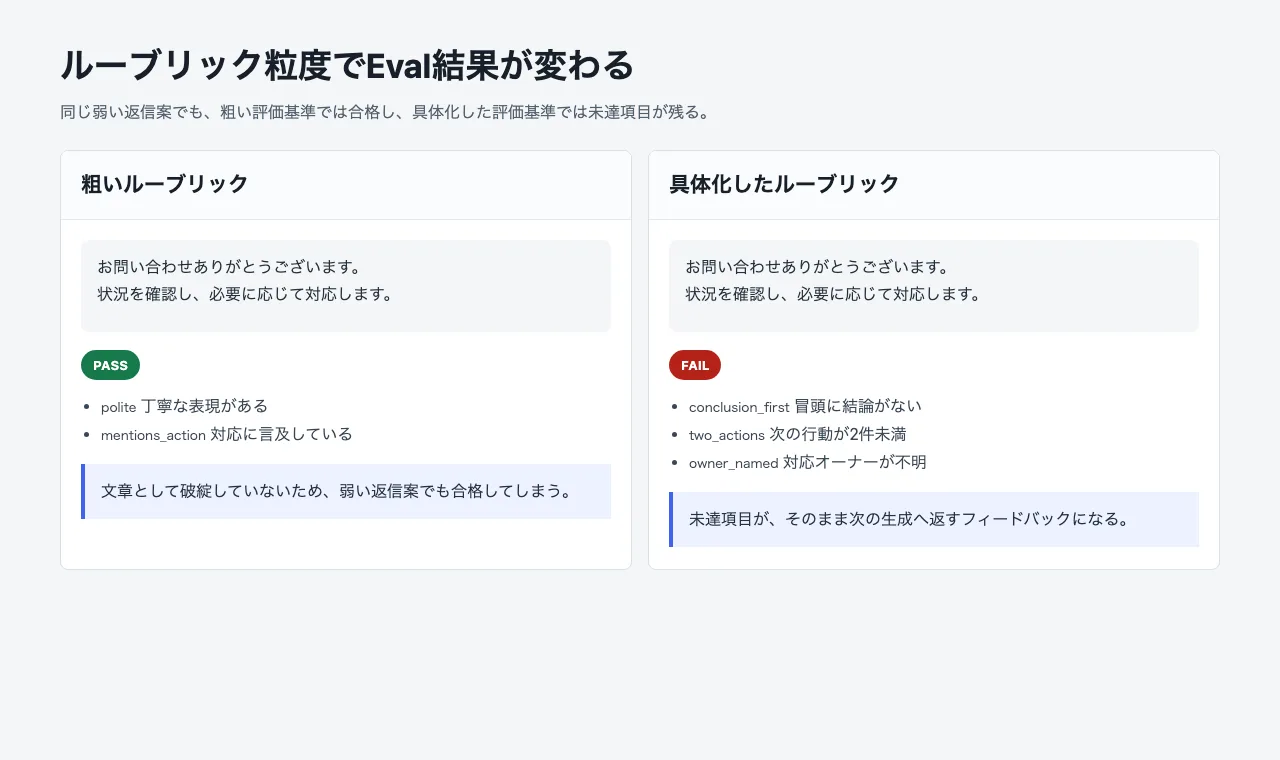
LLMの出力改善ループで、評価基準が粗いままだと弱い出力が合格してしまう問題を、外部APIに依存しない検証スクリプトで確認します。ルーブリックを運用しながら育てるための判断軸を整理しました。
Langfuse AssistantのPublic Betaを、既存のSakana Fugu観測データとPublic APIから計算した正解値で検証します。
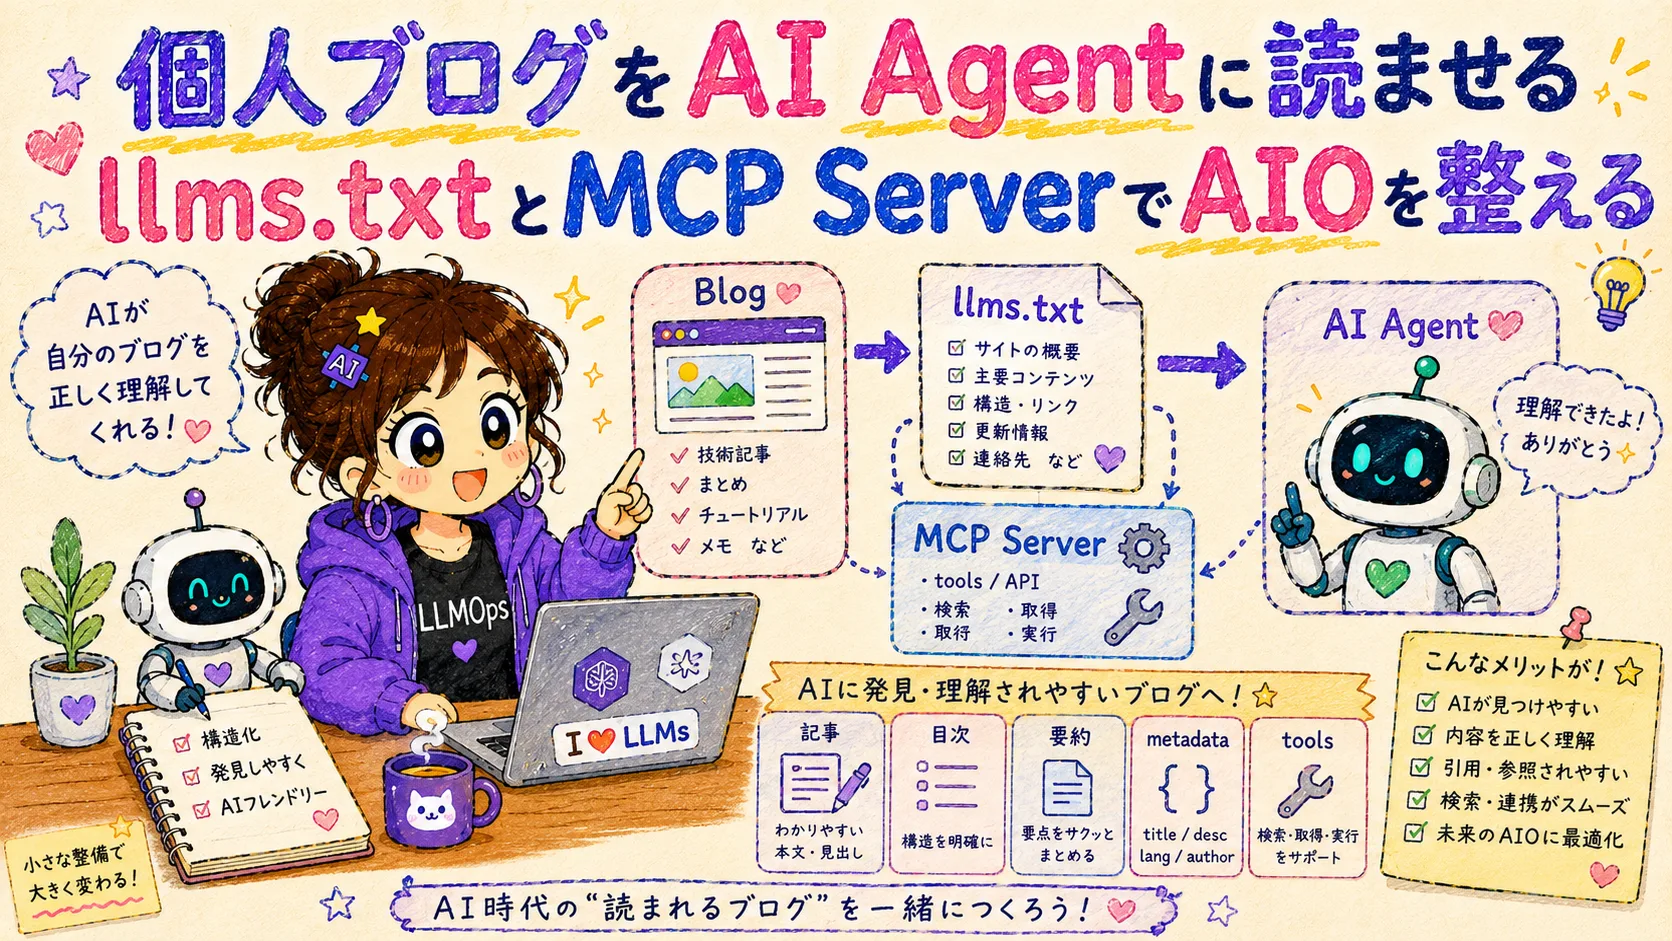
PerplexityやChatGPTが検索の代わりになる中、個人ブログをAI Agentからも発見可能にするAIO(AI最適化)の実装。llms.txt、JSON API、MCP Serverの3層設計と、46本規模での採用判断基準。
生成、評価、フィードバック、再生成を分けた最小ループを検証用スクリプトで実装し、AI出力を安定させるときに見るべき停止条件と評価単位を整理します。
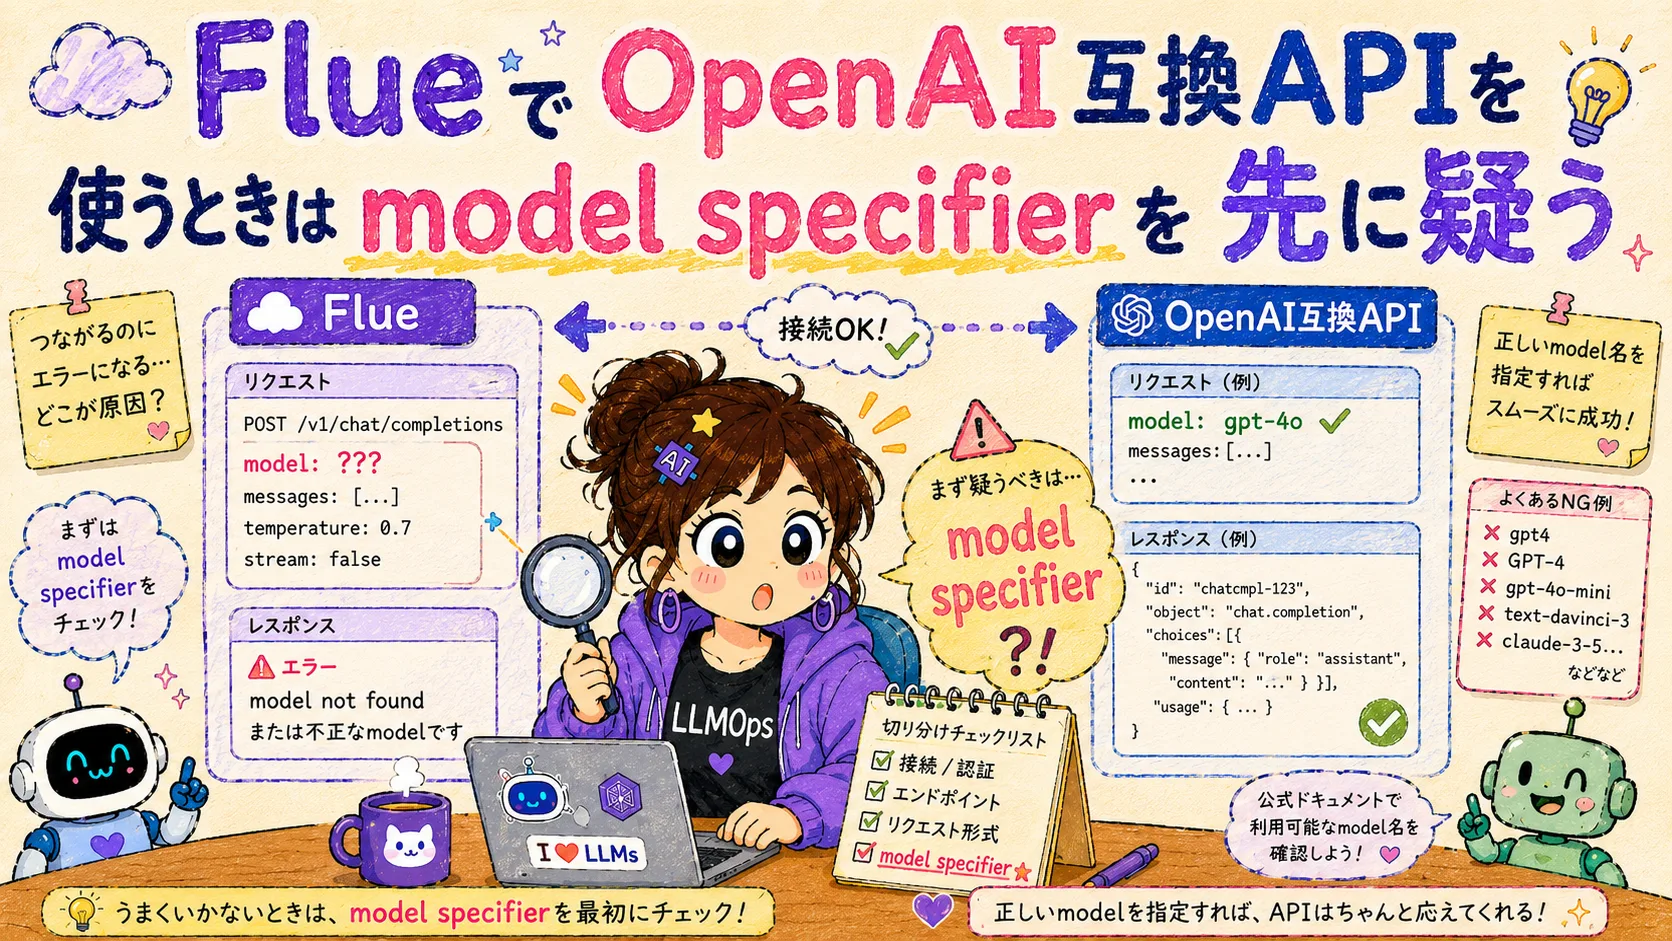
Flue 1.0 BetaでOpenAI互換APIを使う際に、実モデルIDとFlueのprovider-id/model-id形式を混同してUnknown model specifierで止まった検証メモ。
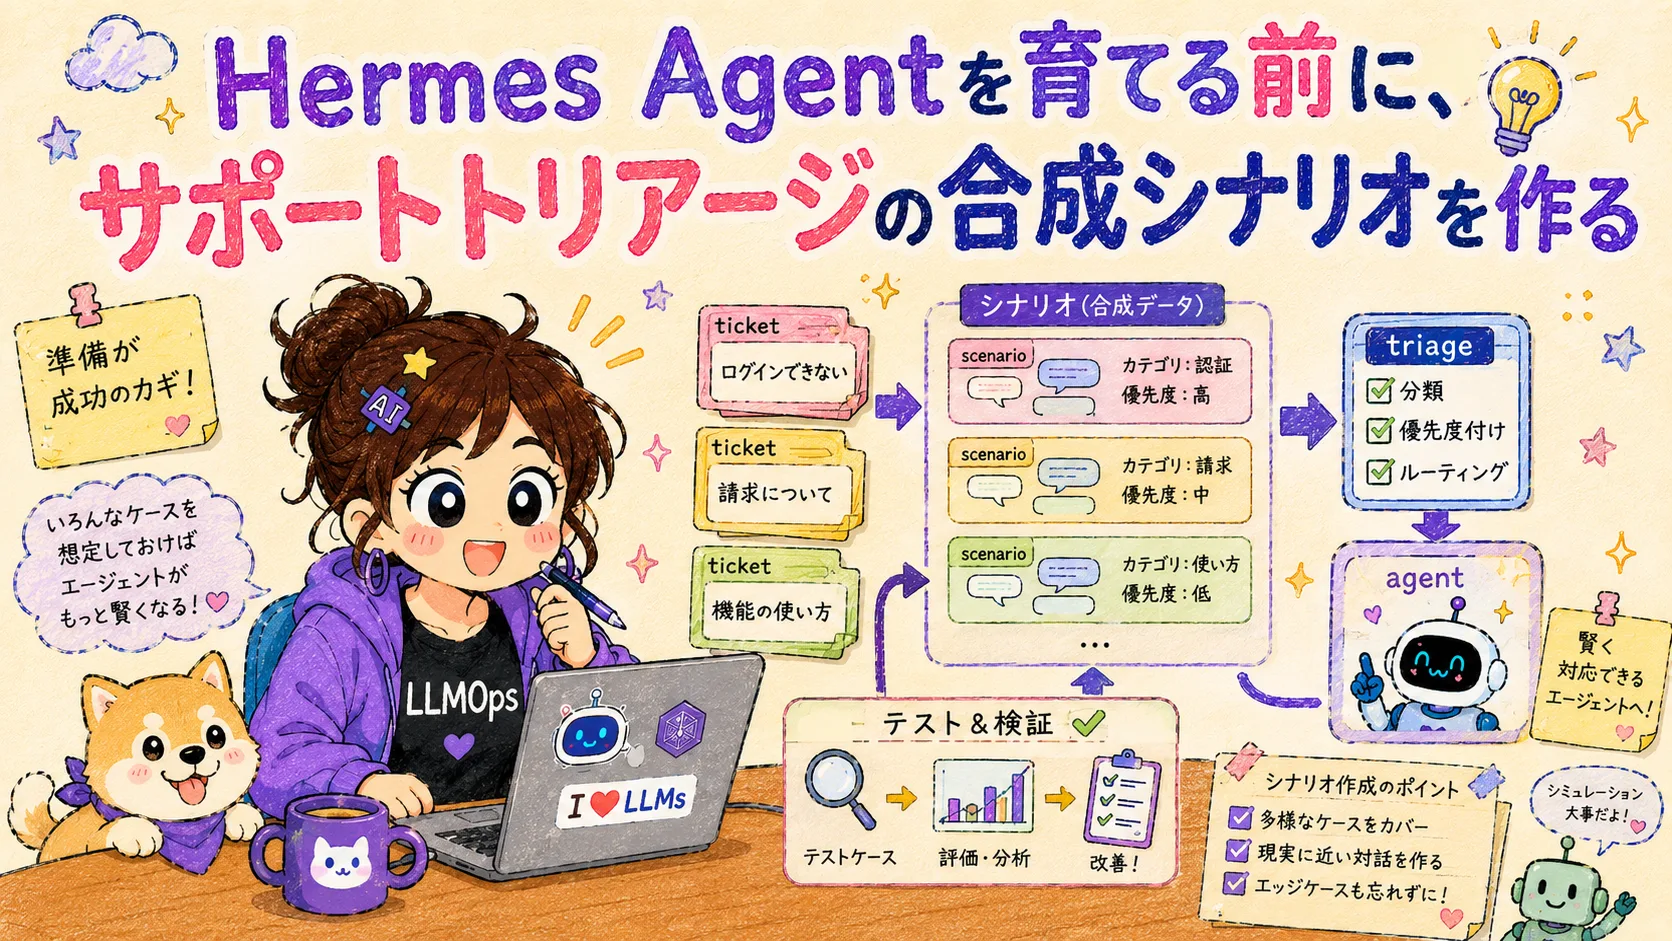
Hermes Agentにサポートトリアージを任せる前段階として、実データを使わずに評価可能な3本の合成シナリオを作り、判断根拠と安全制約を先に固定する。
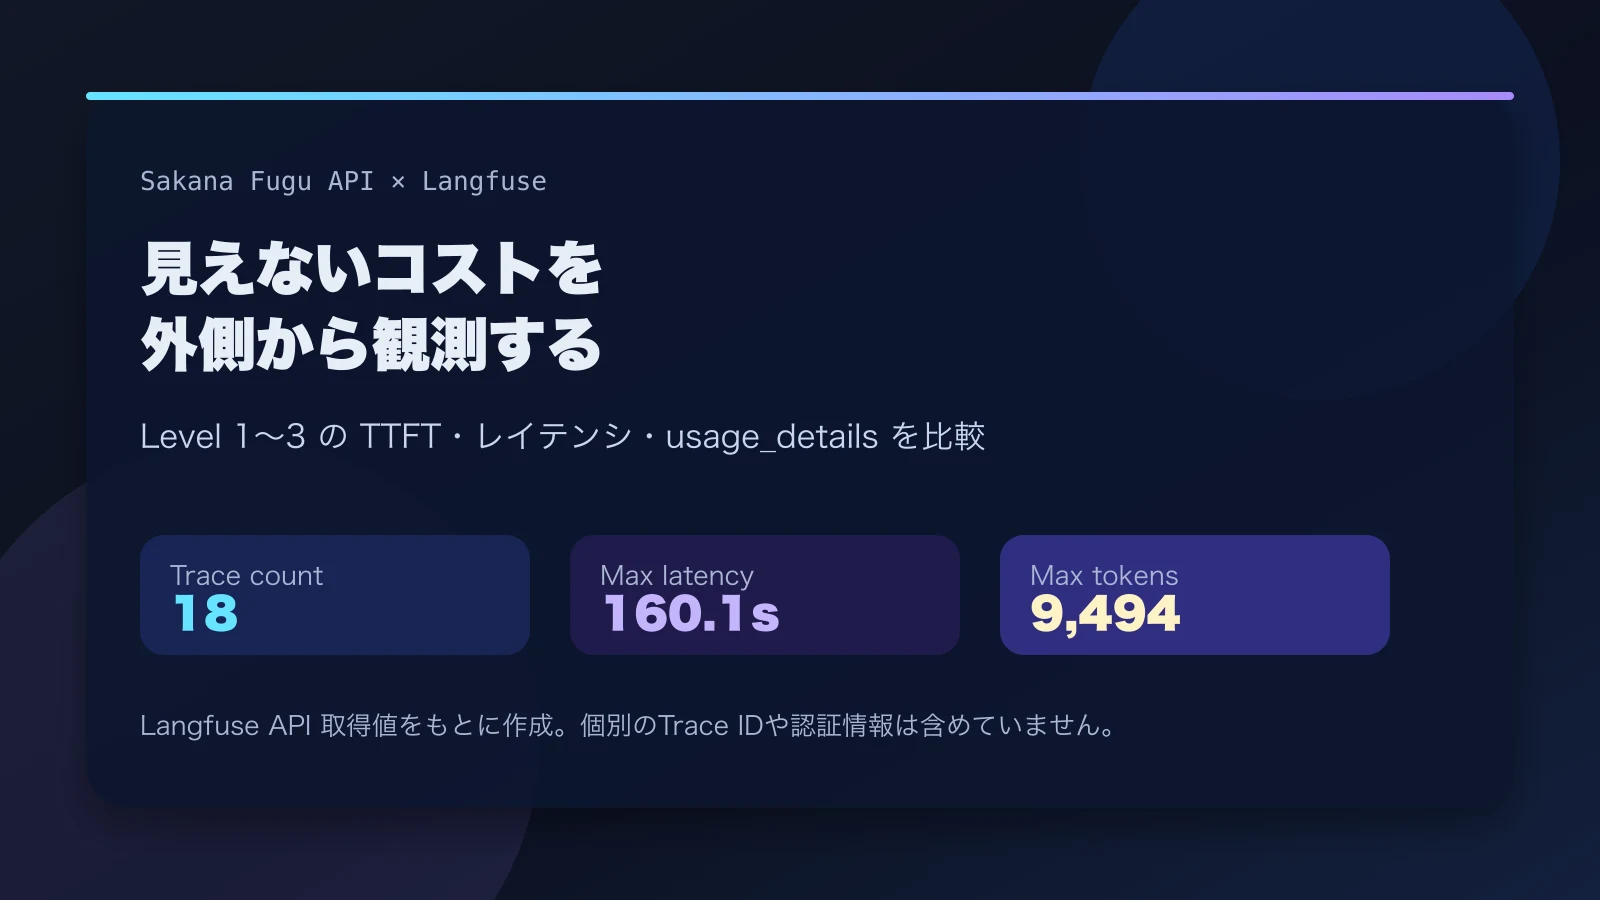
Sakana FuguのOpenAI互換APIをLangfuseで計装し、Level 1〜3のタスクでレイテンシ、消費トークン、TTFTがどう変化するかを観測した実践レポート。
Sakana Fuguをサブスク契約して分かったOpenAI互換APIとしての性質と、ブラックボックスな協調推論を外側から観測するための検証計画。
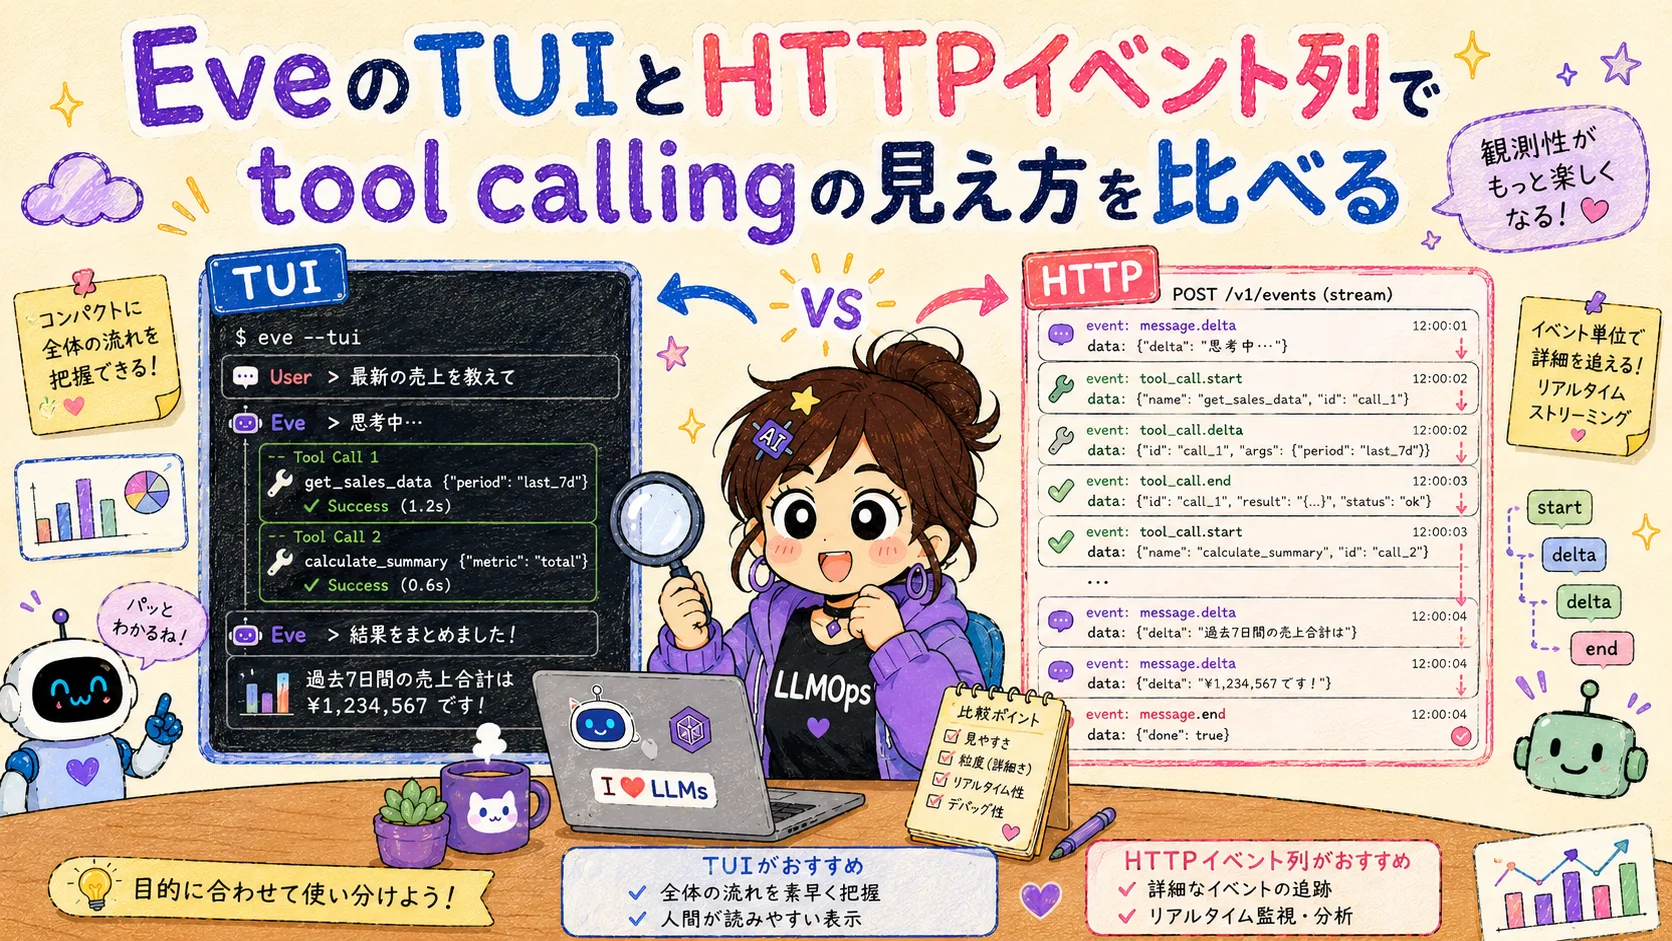
VercelのエージェントフレームワークEveで同じ天気ツール呼び出しをTUIとHTTP APIから観測し、開発者向け表示と外部連携向けイベント列の違いを整理した検証ログ。
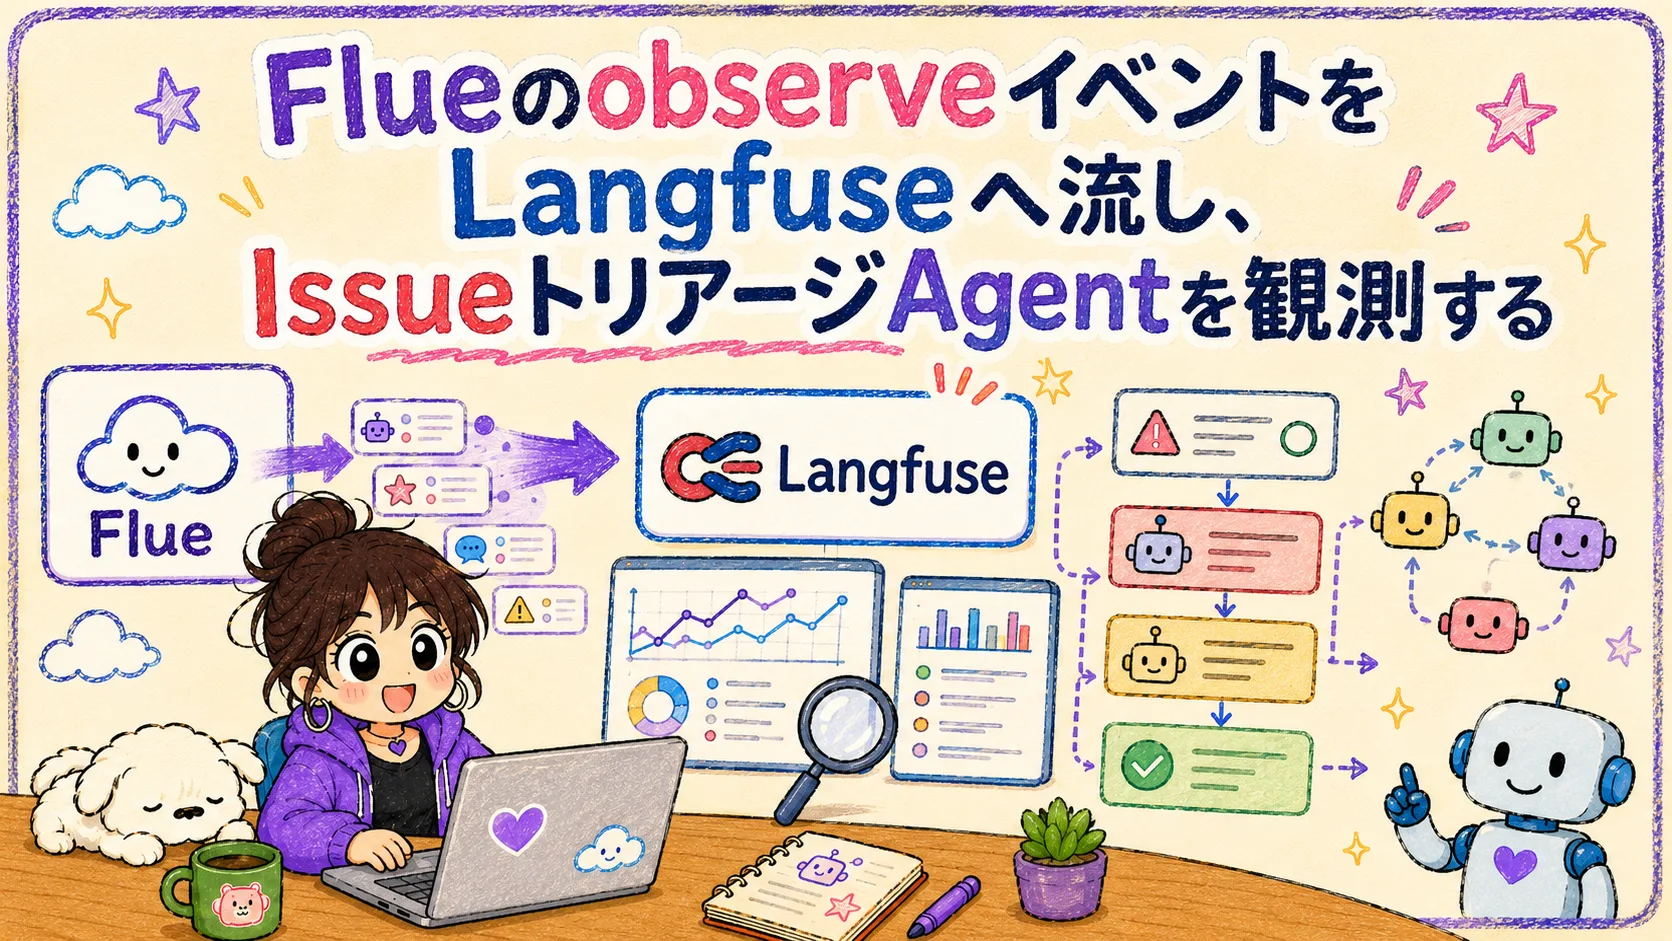
Flue 1.0 BetaのobserveイベントをredactionしたうえでLangfuseへ送信し、IssueトリアージWorkflowのrunId、モデル、結果を追う実験ログ。
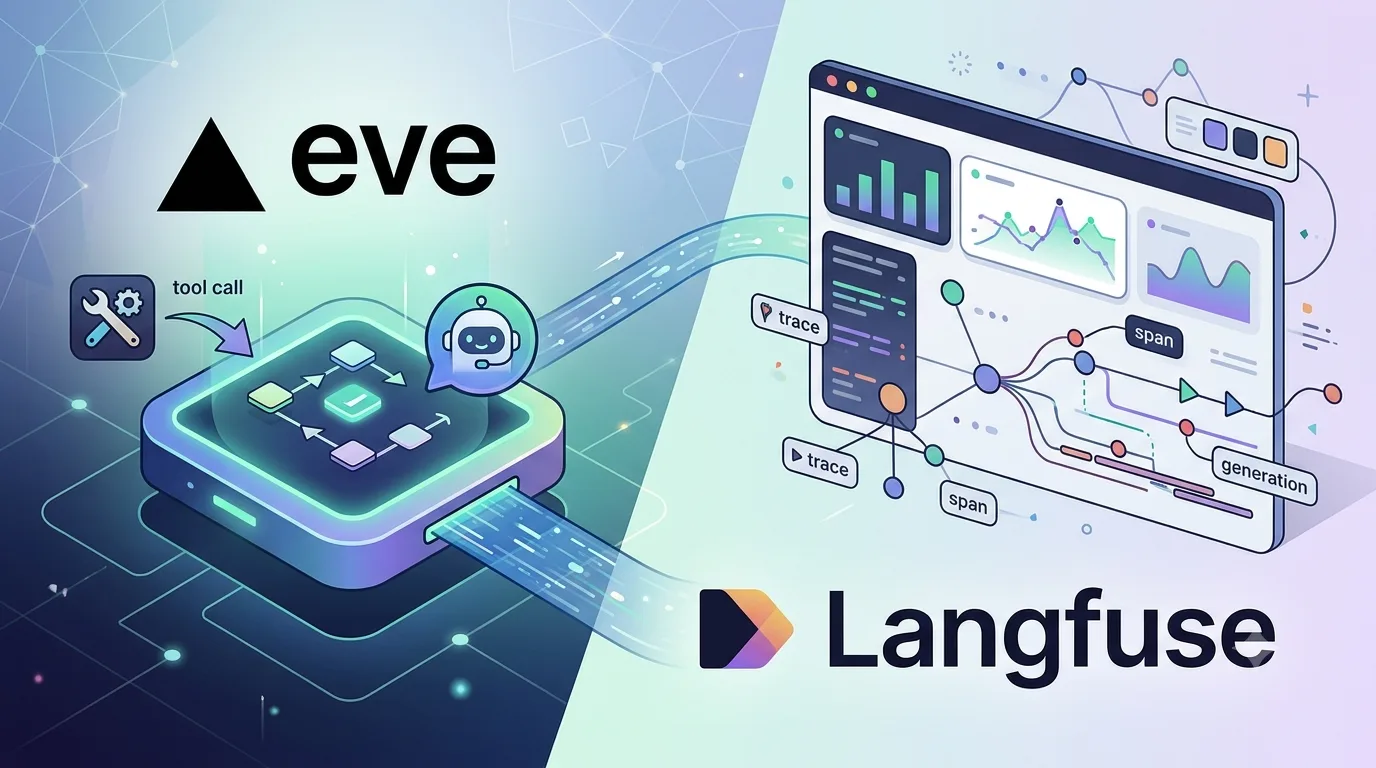
Vercelのエージェントフレームワークeveで動かしたtool calling実行を、Langfuseへtrace/span/generationとして送る方法を2パターン試して比較したログ。